
Kennis
AI-pijplijnen en het idee achter data science
Een AI-pijplijn is een vaste reeks stappen. AI leest, software rekent, mensen beslissen. Zo bouw je er een die je kunt vertrouwen.
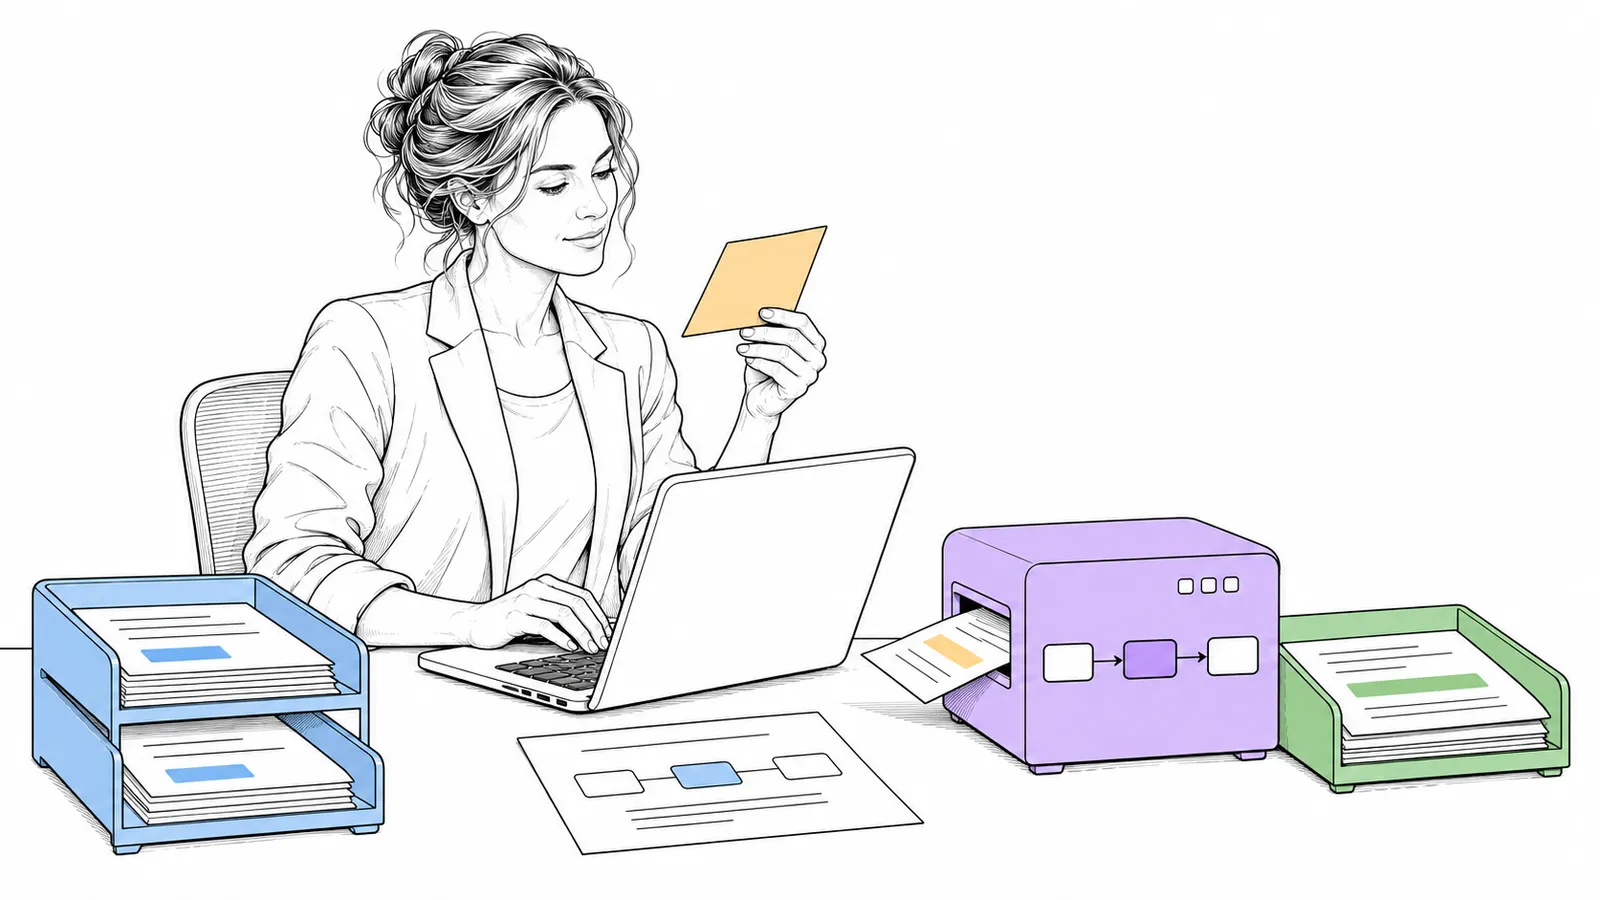
Een AI-pijplijn is een vaste reeks stappen waar data doorheen gaat: binnenhalen, opschonen, uitlezen, controleren, opslaan, tonen. AI doet één of twee van die stappen, niet alles.
In gewone technische taal Een pijplijn is een vaste volgorde van stappen met data als invoer. Een taalmodel leest tekst en zet die om naar velden. Regels en code controleren de velden, en een mens beslist bij twijfel.
Waarom het ertoe doet
Data science is het vak dat met statistiek, code en methode kennis haalt uit rommelige data. Het grootste deel van dat werk is niet het model, maar de data begrijpen. Andrej Karpathy schrijft in zijn recept: de eerste stap is geen code, maar word één met de data. Hij vond zo dubbele voorbeelden en foute labels.
Zet je alles bij een taalmodel neer, dan krijg je elke keer een iets ander antwoord. Voor een factuur of een voorraad wil je dat het klopt, elke keer. Daarom: AI leest, software rekent, mensen beslissen.
Hoe het werkt
Een goedkope check vóór het model, regels erna, en een mens bij twijfel.
Uit een eerder project dat we bestudeerden, een realtime assistent voor klantenservice, namen we vier lessen mee:
- Check vóór je genereert. Te weinig invoer? Dan geen modelaanroep, maar een vaste tekst. Dat scheelt geld en fouten.
- Feiten uit regels, taal uit het model. Een regel bepaalt dat een waarschuwing nodig is; het model maakt er alleen een leesbare zin van.
- Elke stap apart te testen, met een nepversie van de externe systemen.
- Logs met alleen id’s, geen persoonsgegevens.
Wat je doet
- Kijk eerst zelf naar honderd echte voorbeelden van je data.
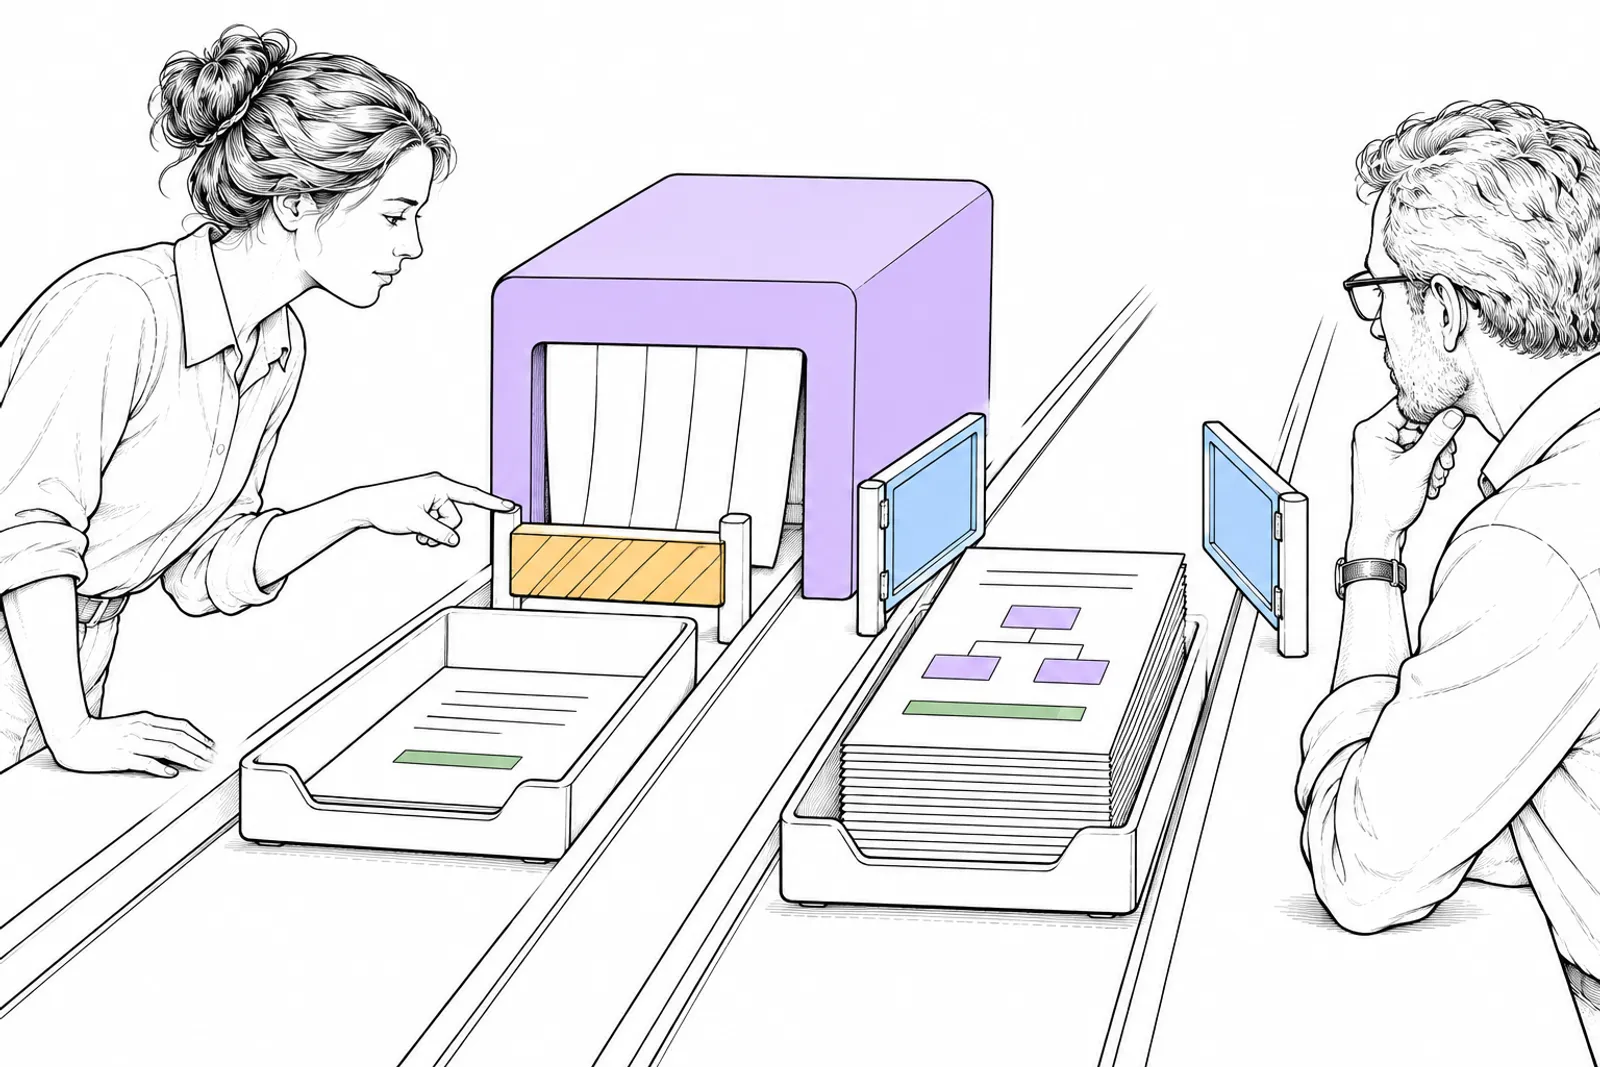
- Teken de stappen. Zet bij elke stap: AI, code of mens.
- Bouw eerst de hele lijn met eenvoudige stappen, en verbeter daarna per stap.
- Meet per stap hoe vaak hij goed is.
Een voorbeeld uit ons eigen werk: voor een zoekmachine vergeleken we een vaste scraping-pijplijn met een agent die zelf zocht. De pijplijn deed er 32 minuten over en vond 49 aanbieders. De agent deed er 10 minuten over en vond er 53.
Wat we met je kunnen doen: we tekenen samen je datastroom en bouwen de pijplijn, met AI alleen waar het helpt. Plan een gesprek.